Jev nas lives: analisando sentimentos do chat do YouTube em tempo quase real
Uma das aplicações que quis experimentar com o Jev foi transformar os comentários de uma live em indicadores de reação da audiência. Montei um protótipo em Python que recebe mensagens do YouTube, analisa cada texto pela API Jev e apresenta os resultados em um painel no localhost.
O objetivo é acompanhar o que a galera está dizendo durante a transmissão: elogios, dúvidas, reclamações e reações curtas que podem passar despercebidas no fluxo do chat.
Veja a aplicação funcionando
Demonstração gravada na minha própria live, com duração de aproximadamente 63 segundos. A gravação foi acelerada em 1,5× e teve as telas do OBS cortadas no início e no fim. Ela mostra a primeira versão, antes da calibração de linguagem descrita abaixo; por estar acelerada, não representa a velocidade original de processamento.
O que aparece no painel
O painel reúne a quantidade total de comentários, a distribuição entre positivos, negativos e neutros e a pontuação média de positividade, de 0 a 100. Essa média considera as mensagens já analisadas; as pendentes aparecem separadamente.
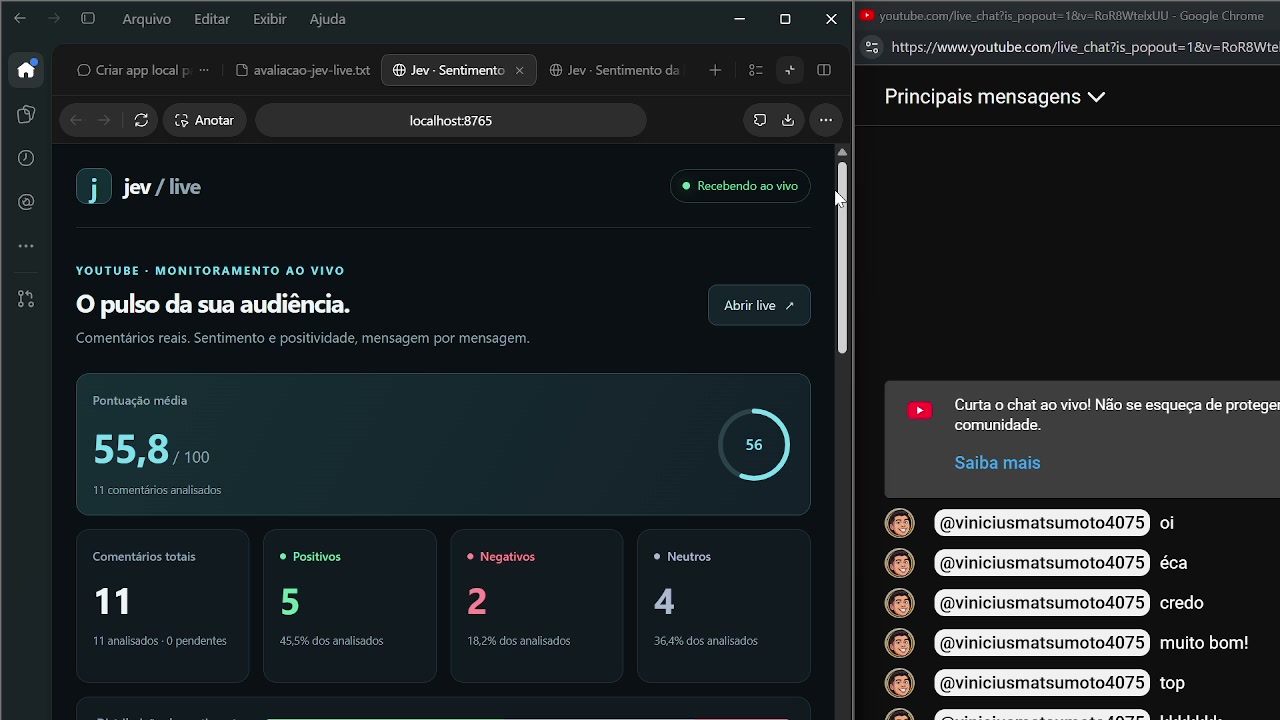
Visão geral durante a gravação: os comentários do YouTube ficam à direita e os indicadores do painel à esquerda.
Também é possível acompanhar cada comentário individualmente: texto, classificação, pontuação de positividade, confiança da classe e tempo de análise. Filtros e busca ajudam a explorar as mensagens, e os detalhes mostram a distribuição de probabilidades retornada pelo modelo.
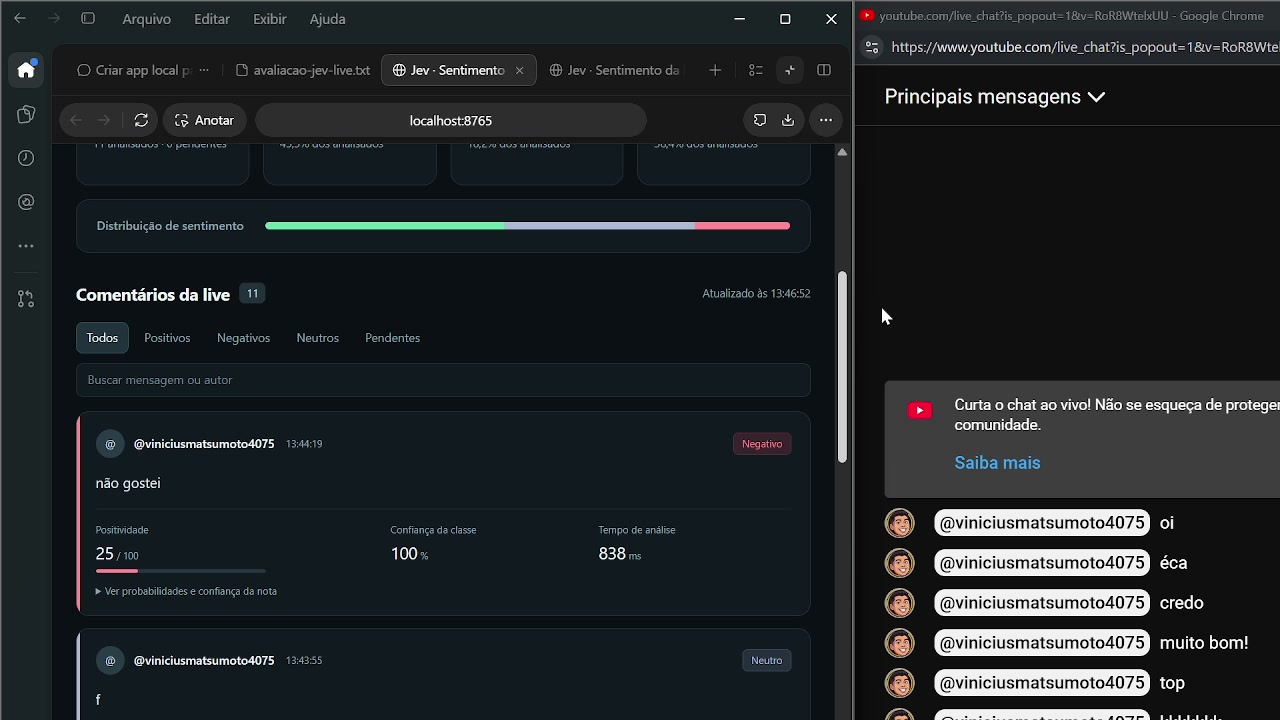
Exemplo de uma mensagem analisada: “não gostei”, classificada como negativa. Os indicadores são resultados daquele teste específico.
Como implementei
A coleta usa a API do YouTube e o fluxo liveChatMessages.streamList, via gRPC. O servidor em Python, com FastAPI, separa a chegada dos comentários da fila de análise. As mensagens e os resultados ficam em SQLite, e a interface consulta o servidor local para atualizar os indicadores.
O painel e o armazenamento rodam na máquina. A classificação acontece na API da TypeSafe AI, usando o Jev. Para a análise, envio o texto do comentário; o nome do autor fica no armazenamento local e na interface.
Usei duas perguntas estruturadas na mesma chamada:
- Choice: seleciona positivo, negativo ou neutro e retorna probabilidades e confiança.
- Score: avalia a positividade em uma rubrica de cinco níveis, cujo resultado é apresentado na escala de 0 a 100.
A confiança retornada pelo modelo ajuda a inspecionar a decisão, mas não é uma medida de acurácia comprovada. A pontuação média também é um indicador definido para este protótipo, não uma métrica validada de satisfação da audiência.
A parte mais interessante: calibrar para pt-BR e contexto de live
Nos primeiros testes, algumas mensagens curtas ficaram como neutras. Dois exemplos foram “f áudio” e expressões de repulsa como “eca” e “credo”.
Em uma live, “f áudio” pode ser uma reclamação de que a transmissão está sem som. Já “eca” e “credo”, usados como reação, podem expressar rejeição ou nojo. Ajustei as instruções e os critérios das duas perguntas para explicitar o idioma português brasileiro (pt-BR) e esse contexto.
O texto completo continua importando: “o áudio voltou, agora está ótimo” deve ser positivo, enquanto “a tecla F abre o menu” é uma informação neutra. Uma regra baseada apenas na presença da letra F não resolveria essa diferença.
| Comentário testado após a calibração | Resultado observado |
|---|---|
| f live / f áudio | Negativo |
| eca / éca / credo | Negativo |
| O áudio voltou, agora está ótimo! | Positivo |
| Qual biblioteca você está usando? | Neutro |
| A tecla F abre o menu | Neutro |
Os dez exemplos enviados à API depois do ajuste receberam as classes esperadas. Isso verifica esses casos, mas ainda não demonstra desempenho em uma amostra ampla de conversas reais.
O que aprendi com o experimento
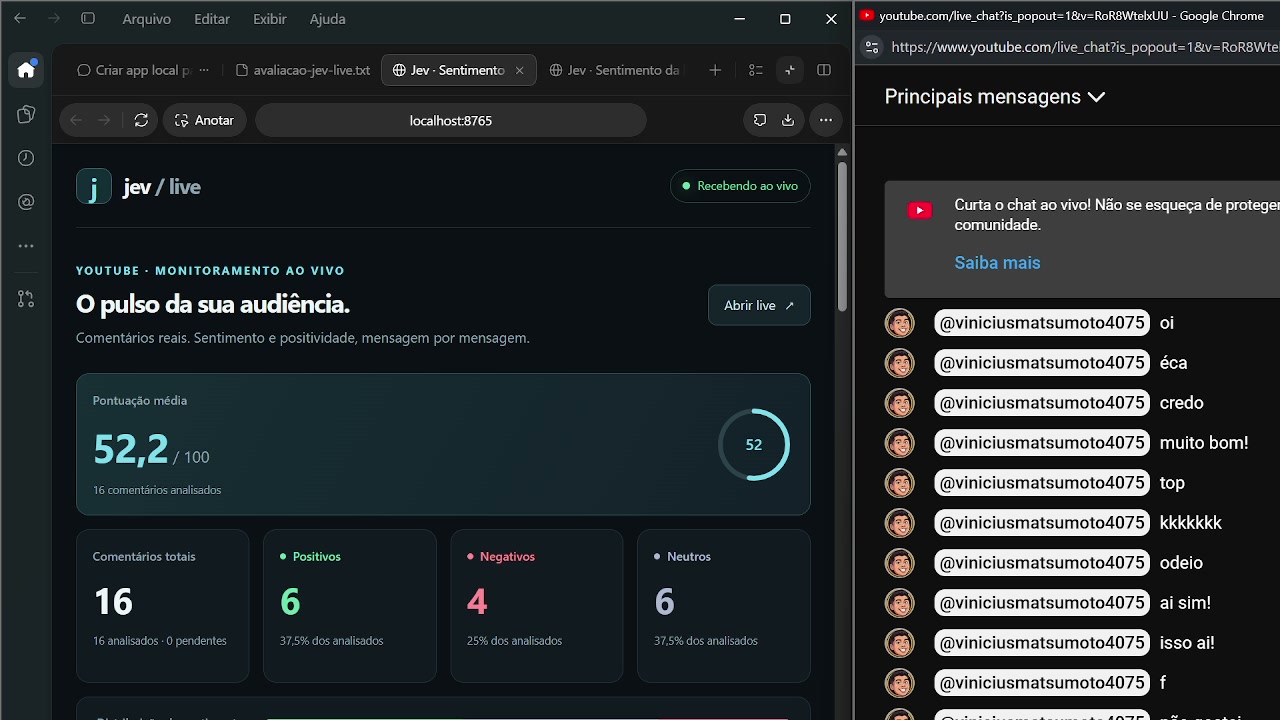
Ao final da gravação, o painel havia recebido 16 comentários. Os números deste print pertencem à primeira versão da rubrica, antes dos ajustes em pt-BR.
Conectar as APIs foi uma parte do trabalho. Definir o que conta como positivo, negativo e neutro nesse ambiente foi outra: uma reclamação técnica sobre o som é uma experiência negativa, mesmo quando não contém insultos ou palavras fortes.
O próximo passo é avaliar uma amostra maior, com classificação humana para comparação, incluindo ironia, gírias, emojis, citações e mensagens ambíguas. Por enquanto, o projeto é uma demonstração prática de como usar decisões estruturadas do Jev para explorar a reação do chat em tempo quase real.